한 줄 결과물: 확인받은 최적화 프롬프트 파일과, ZenMux에서 고른 모델(GPT Image, Nano Banana, FLUX, Seedream, Qwen 등)로 생성·편집해
.context/zenmux-image-generation/output/에 저장한 이미지.
스킬 본문: ../../zenmux-image-generation/SKILL.md
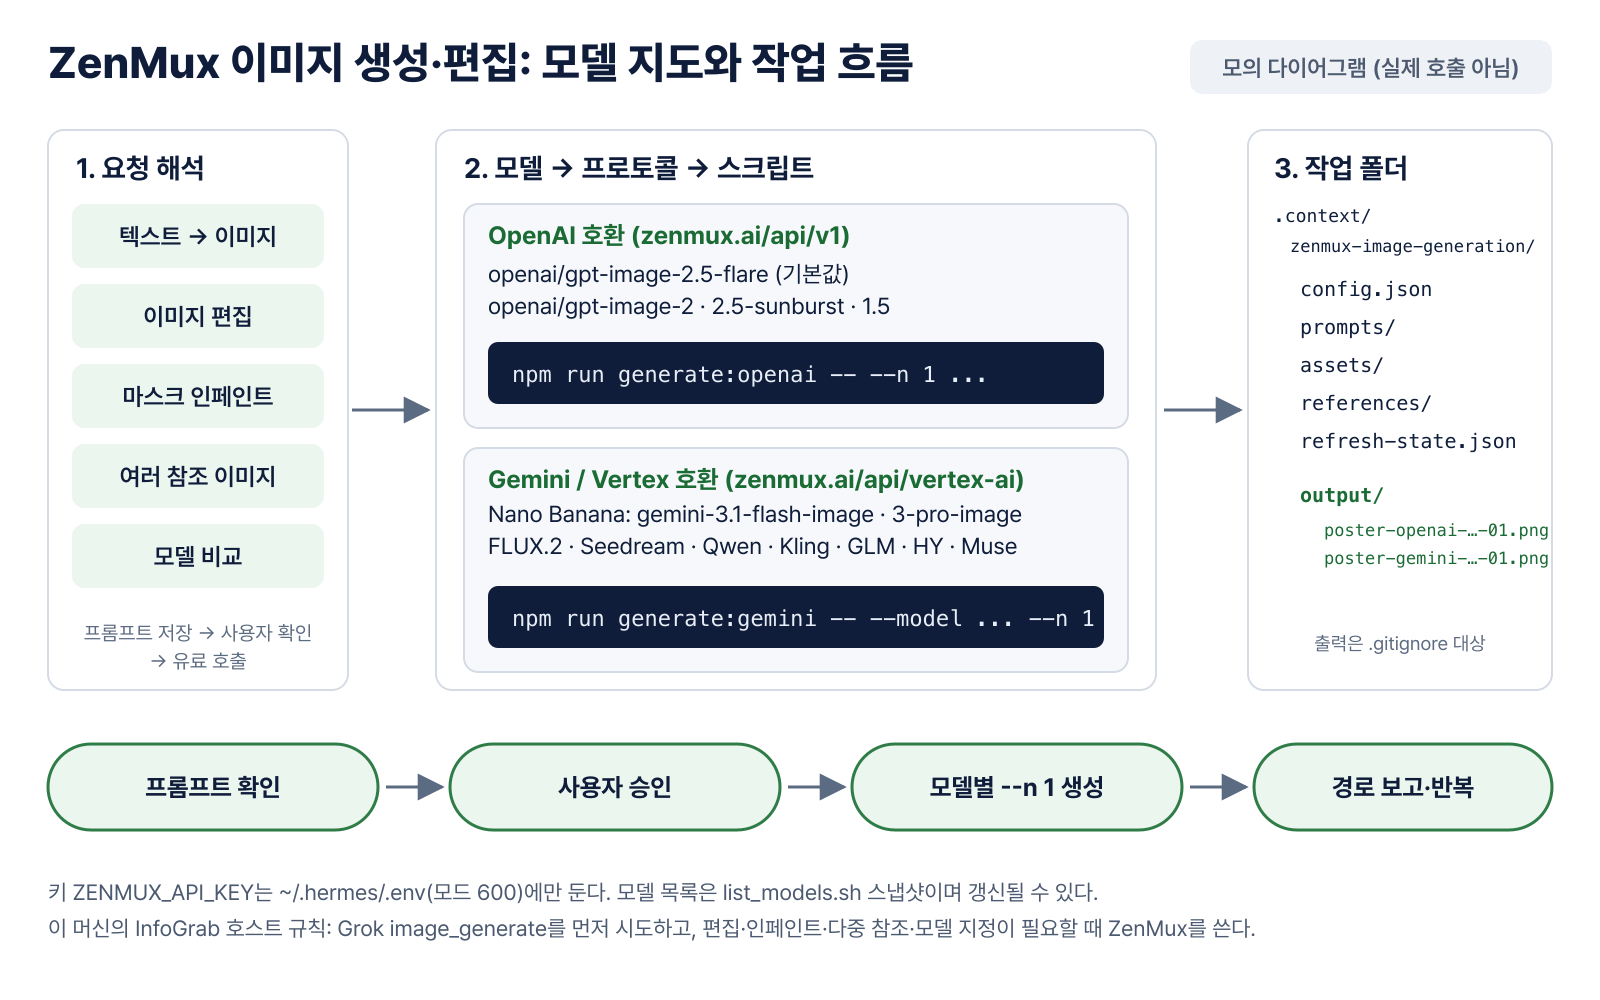
위 그림은 모의 다이어그램이다. 이 저장소를 만든 환경에는
ZENMUX_API_KEY가 없어 실제 ZenMux 호출은 하지 않았다. 그림은 명령, 폴더, 확인 단계의 모양만 보여 준다. 생성 이미지는 들어 있지 않다.
InfoGrab 호스트 메모. 이 머신에서는 일반 이미지 요청을 구독 중인 xAI Grok(
image_generate)으로 먼저 시도한다. 아래 경우에 이 스킬(ZenMux)을 쓴다: Grok 호출이 실패했을 때, 사용자가 ZenMux를 지목했을 때, 편집·인페인트·다중 참조·모델 지정이 필요할 때. ZenMux에서도grok-imagine-*모델은 고르지 않는다. 폴백 호출은--n 1을 넘긴다. 이 메모는 이 머신의 라우팅 규칙이고, 아래 가이드의 나머지는 스킬 자체의 사용법이다.
1. 이 스킬은 무엇인가
사용자의 시각적 의도를 최적화한 프롬프트로 바꾸고, 프롬프트와 파라미터를 사용자에게 확인받은 뒤, ZenMux 하나의 키로 여러 이미지 모델을 호출해 결과를 저장하는 스킬이다. 모델마다 SDK나 키를 따로 준비하지 않는다.
다루는 작업:
| 작업 | 예 |
|---|---|
| 텍스트 → 이미지 | 포스터, 로고, 제품 사진, 인포그래픽, 만화, UI 목업, 패키지 콘셉트 |
| 이미지 편집 | 한 요소만 바꾸고 나머지는 보존, 의상·배경 교체, 리터치 |
| 마스크 인페인트 | PNG 마스크로 지정한 영역만 다시 그리기(OpenAI 계열) |
| 다중 참조 | 번호 붙인 참조 이미지 여러 장을 합성(OpenAI 최대 16장, Gemini 최대 14장) |
| 모델 비교 | 같은 프롬프트를 여러 모델에 한 장씩 돌려 결과를 나란히 보기 |
2. 모델 지도
아래는 스킬에 포함된 스냅샷(references/zenmux-image-models.json, 2026-09-12 기준, 24개)이다. 스냅샷이므로 새 모델이 추가되거나 빠질 수 있다. 모델 ID는 기억으로 쓰지 말고 list_models.sh로 현재 목록을 확인한다(3절).
| 모델 ID | 표시 이름 | 입력 | 출력 | 프로토콜 |
|---|---|---|---|---|
bfl/flux-2-flex | Black Forest Labs: FLUX.2 Flex | image, text | image | Gemini/Vertex |
bfl/flux-2-max | Black Forest Labs: FLUX.2 Max | image, text | image | Gemini/Vertex |
bfl/flux-2-pro | Black Forest Labs: FLUX.2 Pro | image, text | image | Gemini/Vertex |
bytedance/doubao-seedream-5.0-lite | ByteDance: Doubao-Seedream-5.0-lite | image, text | image | Gemini/Vertex |
bytedance/doubao-seedream-5.0-pro | ByteDance: Doubao-Seedream-5.0-pro | image, text | image | Gemini/Vertex |
google/gemini-2.5-flash-image | Google: Gemini 2.5 Flash Image (Nano Banana) | image, text | image, text | Gemini/Vertex |
google/gemini-3-pro-image | Google: Nano Banana Pro (Gemini 3 Pro Image) | image, text | image, text | Gemini/Vertex |
google/gemini-3.1-flash-image | Google: Nano Banana 2 (Gemini 3.1 Flash Image) | image, text, video | image, text | Gemini/Vertex |
google/gemini-3.1-flash-lite-image | Google: Nano Banana 2 Lite (Gemini 3.1 Flash-Lite Image) | image, text | image, text | Gemini/Vertex |
klingai/kling-v2 | KlingAI: Kling-v2 | image, text | image | Gemini/Vertex |
klingai/kling-v3 | KlingAI: Kling-v3 | image, text | image | Gemini/Vertex |
meta/muse-image-1.0 | Meta: Muse Image 1.0 | image, text | image | Gemini/Vertex |
openai/gpt-image-1.5 | OpenAI: GPT-Image-1.5 | image, text | image | OpenAI |
openai/gpt-image-2 | OpenAI: GPT-Image-2 | image, text | image | OpenAI |
openai/gpt-image-2.5-flare | OpenAI: GPT-Image-2.5-Flare | image, text | image | OpenAI |
openai/gpt-image-2.5-sunburst | OpenAI: GPT-Image-2.5-Sunburst | image, text | image | OpenAI |
qwen/qwen-image-2.0 | Qwen: Qwen-Image-2.0 | image, text | image | Gemini/Vertex |
qwen/qwen-image-2.0-pro | Qwen: Qwen-Image-2.0-Pro | image, text | image | Gemini/Vertex |
qwen/qwen-image-3.0 | Qwen: Qwen-Image-3.0 | image, text | image | Gemini/Vertex |
qwen/qwen-image-3.0-pro | Qwen: Qwen-Image-3.0-Pro | image, text | image | Gemini/Vertex |
sapiens-ai/agnes-image-2.1-flash | Sapiens AI: Agnes Image 2.1 Flash | image, text | image | Gemini/Vertex |
tencent/hy-image-v3.0 | Tencent: HY-Image-V3.0 | image, text | image | Gemini/Vertex |
x-ai/grok-imagine-image-2.0 (선택 금지) | Grok Imagine Image 2.0 | image, text | image | Gemini/Vertex |
z-ai/glm-image | Z.AI: GLM-Image | text | image | Gemini/Vertex |
모델 고르는 감각(SKILL 3절의 추천):
| 필요 | 추천 모델 |
|---|---|
| 기본값 | 프로젝트 설정의 generation.model(공장 기본값 openai/gpt-image-2.5-flare) |
| 이전 세대 OpenAI | openai/gpt-image-1.5 |
| Nano Banana 기본 | google/gemini-3.1-flash-image |
| 가장 빠른 Nano Banana | google/gemini-3.1-flash-lite-image(1K만, 복잡한 다중 참조·연속 편집에는 부적합) |
| 복잡한 전문 에셋 | google/gemini-3-pro-image |
| 중문 포스터·제품 디자인 | qwen/qwen-image-3.0-pro, bytedance/doubao-seedream-5.0-pro |
| 사실적 사진, 유연한 창작 | bfl/flux-2-max, bfl/flux-2-flex, bfl/flux-2-pro |
| 그 밖의 선택지 | klingai/kling-v3, sapiens-ai/agnes-image-2.1-flash, tencent/hy-image-v3.0, z-ai/glm-image |
카탈로그에 있다는 것은 모델 ID가 있다는 뜻이지, 모든 파라미터를 지원한다는 뜻이 아니다. 새 모델은 선택한 프로토콜을 현재 ZenMux 문서로 확인한다. z-ai/glm-image는 입력이 텍스트뿐이라 편집 용도가 아니다.
3. 프로토콜과 스크립트
모델 ID로 스크립트가 정해진다.
| 모델 | 스크립트 | 엔드포인트 |
|---|---|---|
openai/gpt-image-*, 맨 gpt-image-*, chatgpt-image-latest | npm run generate:openai | https://zenmux.ai/api/v1 (OpenAI Images) |
| 그 밖의 모든 모델 | npm run generate:gemini | https://zenmux.ai/api/vertex-ai (Gemini/Vertex 호환) |
| 사용자가 OpenAI 모델을 Gemini 프로토콜로 호출하라고 명시 | npm run generate:gemini | 위와 같음 |
generate:gemini 안에서도 갈래가 나뉜다.
- Google Gemini 이미지 모델:
generateContent(--stream이면 스트리밍). 항상TEXT와IMAGE를 요청하고,--aspect-ratio와--image-size로imageConfig를 만든다. - Google 외 모델:
generateImages, 참조 이미지가 있으면editImage.--negative-prompt,--seed,--guidance-scale,--enhance-prompt,--person-generation,--safety-filter-level,--include-rai-reason,--add-watermark를 쓸 수 있다. - GPT Image의
background(투명 배경)는 Vertex 경로에 없다. 투명 PNG/WebP는generate:openai로 만든다. - Google의 Interactions API는 ZenMux가 문서화하지 않았다. ZenMux에서는
generateContent와generateImages/editImage를 그대로 쓴다.
기본 모델은 번들 config.json.example의 openai/gpt-image-2.5-flare, 기본 장수는 4, 크기 1024x1024, 품질 medium, 형식 png이다. 우선순위는 사용자 요청과 CLI 플래그 > 프로젝트 config.json > 예시 기본값이다.
4. 작업 폴더와 설정
스킬이 어디에 설치돼 있든 런타임 파일은 현재 프로젝트의 .context/zenmux-image-generation/에 생긴다(Git 루트 기준, Git 밖이면 호출한 디렉터리).
.context/zenmux-image-generation/
  .gitignore         # 생성물은 무시, .gitignore와 config.json만 Git 허용
  config.json        # 사용자 설정(없을 때만 config.json.example에서 복사)
  refresh-state.json # 자료별 갱신 시도·성공 기록
  output/            # 생성된 이미지
  prompts/           # 최적화한 프롬프트와 파라미터
  assets/            # 이 작업을 위해 복사·내려받은 참조 이미지
  references/        # 갱신된 문서, 쿡북, 모델 캐시
# 스킬 폴더 경로를 한 번 정해 두면 아래 명령을 그대로 붙여 넣을 수 있다.
SKILL=~/.hermes/skills/creative/zenmux-image-generation # 설치 위치에 맞게 바꾼다
node "$SKILL/scripts/workspace.mjs" # 폴더와 .gitignore 만들기, 절대 경로 출력
node "$SKILL/scripts/workspace.mjs" --config # 적용되는 설정 보기| 설정 | 공장 기본값 | 뜻 |
|---|---|---|
generation.model | openai/gpt-image-2.5-flare | 기본 모델 |
generation.count | 4 | 장수(1-10) |
generation.size | 1024x1024 | 크기. 모델별 검증은 따로 적용 |
generation.quality | medium | low, medium, high, auto |
generation.outputFormat | png | png, jpeg, webp |
prompt.mode | direct | direct 또는 reference(8절) |
refresh.autoUpdate | true | 자동 네트워크 갱신 허용. false면 로컬·번들 자료만 쓴다 |
refresh.referencesIntervalHours | 168 | 문서·쿡북 갱신 주기(7일) |
refresh.modelsIntervalHours | 24 | 모델 카탈로그 갱신 주기(1일) |
refresh.retryIntervalMinutes | 60 | 갱신 실패 시 재시도 대기 |
일회성 요청(이번만 다른 모델, 이번만 reference 모드)은 이번 호출에만 적용하고, 사용자가 저장 설정을 바꾸자고 할 때만 프로젝트 config.json을 고친다. 공유 예시 파일에는 개인 설정을 쓰지 않는다. 설정이 깨져 있으면 덮어쓰지 말고 경로가 찍힌 오류를 고친다.
키
ZENMUX_API_KEY는 설정 파일이 아니라 ~/.hermes/.env의 한 줄에만 둔다(모드 600, = 앞뒤 공백 없음).
ZENMUX_API_KEY=<키>- 채팅, CLI 인자,
hermes config set인자로 받지 않고 출력하지 않는다. 쉘 기록에 남는다. - 쓴 뒤에는 새 세션을 시작한다(게이트웨이를 쓰면 게이트웨이도 재시작).
- 있는지만 확인한다:
grep -c '^ZENMUX_API_KEY=.' ~/.hermes/.env가 1이면 설정됨. - 종량제 키는
sk-ai-v1-, 구독 키는sk-ss-v1-로 시작한다. 키를 지어내지 않는다. - 생성 스크립트는 터미널 도구로 실행한다.
execute_code샌드박스는KEY가 들어간 환경 변수 이름을 지운다.
5. 전체 흐름(SKILL 1-8 요약)
| 단계 | 하는 일 | 핵심 |
|---|---|---|
| 1. 준비·갱신 | Node.js 22+, curl, jq. npm ci --prefix "$SKILL"(클론당 한 번). refresh_references.sh --quiet로 주기가 지난 자료만 갱신 | --force는 사용자가 즉시 갱신을 원할 때만. direct 모드에서는 쿡북을 받지 않는다 |
| 2. 의도 해석 | 주제·변화, 스타일, 참조 이미지, 모델, 크기, 품질, 장수, 정확한 문구, 파일명 접두사 | 결과를 실제로 바꾸는 빠진 정보만 최대 3개 질문. 참조는 사용자 순서대로 [Image #1], [Image #2]로 번호 |
| 3. 모델·프로토콜 | 사용자가 모델을 지정했으면 보존. 아니면 list_models.sh로 현재 목록 확인 | 모델 ID는 지어내지 않는다. 2·3절 표로 스크립트 결정 |
| 4. OpenAI 모범 사례 | 생성은 images.generate, 편집은 images.edit | 아래 목록 참고 |
| 5. 프롬프트 최적화·저장 | prompts/<YYYYMMDD-HHMMSS>-<slug>.md에 저장하고 사용자에게 보여 준다 | 확인 전에는 유료 호출 금지. 작은 수정은 같은 파일을 고친다 |
| 6. 생성 | 3절 표의 스크립트 실행 | 폴백·비교 호출은 --n 1 |
| 7. 안전한 파일명 | <접두사>-<모델슬러그>-<UTC밀리초>-<8자리런ID>-<번호>.<확장자> | 소문자 ASCII, 덮어쓰지 않음. 항상 짧은 영어 --filename-prefix를 넘긴다 |
| 8. 보고·반복 | SUCCESS, OUTPUT_DIR, IMAGE_PATHS, RESULT_JSON을 읽고 절대 경로를 알려 준다 | 후속 편집은 고른 이미지를 [Image #1]로 두고 불변 조건을 매번 다시 적는다 |
4단계의 OpenAI 규칙:
- 생성 결과는
b64_json이며 트랜스코딩 없이 저장한다. - 투명 배경은
--background transparent에 PNG 또는 WebP를 함께 지정한다. PNG만 요청해서는 알파 채널이 생기지 않는다(gpt-image-2투명 출력은 현재 프리뷰). - 압축(
--compression)은 JPEG와 WebP에만 적용된다. - 편집은 입력 이미지 최대 16장, 순서 유지. 마스크는 첫 번째 입력에 적용되고, PNG, 4MB 미만, 첫 이미지와 같은 크기여야 한다. 완전히 투명한 영역이 편집 대상이다.
gpt-image-2는 입력을 항상 고충실도로 처리하므로--input-fidelity를 생략한다. 이전 GPT Image 모델에서 인물 보존이 중요하면--input-fidelity high를 쓴다.gpt-image-2사용자 지정 크기: 두 변 모두 16의 배수, 비율 1:3~3:1, 총 픽셀 655,360~8,294,400.2560x1440초과는 실험적이고 최대는3840x2160이다.gpt-image-2.5-flare는 사용자 지정 크기 한도가 문서화되기 전까지 프리셋(auto,1024x1024,1536x1024,1024x1536)을 쓴다.
크기 단축어: 세로·휴대폰 배경·스토리는 1024x1536, 가로·배너·와이드는 1536x1024, 정사각·로고·아이콘·소셜 게시물은 1024x1024, gpt-image-2의 4K는 3840x2160, 2K는 2560x1440.
6. 따라하기 레시피
준비(한 번)
SKILL=~/.hermes/skills/creative/zenmux-image-generation   # 설치 위치에 맞게
npm ci --prefix "$SKILL"
node "$SKILL/scripts/workspace.mjs"
grep -c '^ZENMUX_API_KEY=.' ~/.hermes/.env                 # 1이면 키가 있다. 값은 출력하지 않는다
bash "$SKILL/scripts/refresh_references.sh" --quiet
bash "$SKILL/scripts/list_models.sh" --names-only          # 지금 쓸 수 있는 모델 ID
모든 생성 명령 앞에는 머신 환경에 따라 NODE_EXTRA_CA_CERTS=/opt/homebrew/etc/ca-certificates/cert.pem을 붙인다(9절). 아래 예시는 줄을 짧게 하려고 생략했다.
프롬프트 파일은 5단계 형식(메타데이터, ---, 프롬프트 본문)으로 prompts/에 저장하고 사용자 확인을 받은 뒤 호출한다. 에이전트에게는 이렇게 요청한다.
zenmux-image-generation 스킬로 신제품 출시 포스터를 만들어 줘.
모델은 기본값, 세로 구도. 프롬프트와 파라미터를 먼저 보여 주고,
내가 확인하기 전에는 유료 생성을 호출하지 마.
(a) 텍스트 → 이미지: OpenAI / GPT Image
npm --prefix "$SKILL" run generate:openai -- \
  --prompt-file ".context/zenmux-image-generation/prompts/poster.md" \
  --filename-prefix "launch-poster" \
  --size "1024x1536" --quality "high" --n 1
기본 모델(generation.model)을 쓰므로 --model은 생략했다. 투명 로고가 필요하면 --background transparent --output-format png를 더한다.
(b) 텍스트 → 이미지: Gemini / Nano Banana + 비율
npm --prefix "$SKILL" run generate:gemini -- \
  --model "google/gemini-3.1-flash-image" \
  --prompt-file ".context/zenmux-image-generation/prompts/poster.md" \
  --filename-prefix "campaign-poster" \
--aspect-ratio "2:3" --image-size "1K" --n 1--aspect-ratio와 --image-size를 생략하면 공급자 기본값이 적용돼 모델마다 결과 크기가 달라진다. 비율을 지켜야 하면 항상 명시한다. FLUX, Seedream, Qwen 같은 Google 외 모델도 같은 스크립트에서 --model만 바꿔 호출한다.
(c) 이미지 편집 / 인페인트
참조 이미지를 순서대로 넘긴다(로컬 경로, file://, http(s)://, base64 data URL). 프롬프트에는 [Image #1]처럼 같은 번호를 쓰고, 바꿀 것을 먼저, 보존할 것을 그다음에 적는다.
Change only the jacket color of the person in [Image #1] to deep navy.
Preserve identity, pose, geometry, camera angle, lighting, framing, background, and all unmentioned details.
# OpenAI 편집: 참조 순서 유지, 마스크는 첫 번째 이미지에 적용
npm --prefix "$SKILL" run generate:openai -- \
--prompt-file ".context/zenmux-image-generation/prompts/jacket-edit.md" \
--filename-prefix "jacket-edit" --quality "high" --n 1 \
--reference-image "/absolute/path/person.png" \
--reference-image "https://example.com/jacket.webp" \
--mask-image "/absolute/path/mask.png" # 인페인트일 때만
# Gemini 편집: 최대 14장 참조
npm --prefix "$SKILL" run generate:gemini -- \
--model "google/gemini-3.1-flash-image" \
--prompt-file ".context/zenmux-image-generation/prompts/jacket-edit.md" \
--filename-prefix "jacket-edit" --reference-image "/absolute/path/person.png" --n 1후속 편집은 방금 고른 결과를 [Image #1]로 두고 불변 조건을 처음부터 다시 적는다.
(d) 모델 비교: 모델마다 --n 1
같은 프롬프트 파일, 같은 접두사로 모델만 바꿔 한 장씩 만든다. 파일명에 모델 슬러그와 런 ID가 들어가므로 서로 덮어쓰지 않는다. 호출 수만큼 과금되므로 비교 대상 모델과 호출 수를 사용자에게 먼저 보여 주고 승인받는다.
P=".context/zenmux-image-generation/prompts/poster.md"

npm --prefix "$SKILL" run generate:openai -- --prompt-file "$P" \
  --model "openai/gpt-image-2.5-flare" --filename-prefix "cmp-poster" --n 1

for M in google/gemini-3.1-flash-image bfl/flux-2-max qwen/qwen-image-3.0-pro; do
  npm --prefix "$SKILL" run generate:gemini -- --prompt-file "$P" \
    --model "$M" --filename-prefix "cmp-poster" --aspect-ratio "2:3" --n 1
done
결과는 output/에 cmp-poster-<모델슬러그>-...-01.png 식으로 쌓인다. 비교 뒤에는 마음에 든 모델 하나로 정식 생성이나 편집을 이어 간다.
7. 결과를 확인하고 보고하기
성공하면 스크립트가 SUCCESS, OUTPUT_DIR, IMAGE_PATHS, 한 줄짜리 RESULT_JSON을 출력한다. 다른 도구가 결과를 이어받으면 RESULT_JSON을 파싱하고, 사용자에게는 클릭할 수 있는 절대 경로를 알려 준다. 저장된 파일은 반드시 실제로 열어 보고(해상도, 비율, 문구 오탈자, 요청한 구성) 맞는지 확인한 뒤 보고한다.
8. 프롬프트 작성 체크리스트
프롬프트 최적화는 호출하는 모델이 직접 한다. prompt.mode 설정은 이미지 API로 전달되지 않고 추가 유료 호출도 만들지 않는다.
direct(기본): 사용자 요청, 제공된 이미지, 호출 모델의 판단만으로 최적화한다. 쿡북이나 웹에서 예시를 빌리지 않는다.reference: 쿡북에서 관련 예시 몇 개를 찾아 사용자 의도에 맞게 바꾼다. 쓴 쿡북과 항목을 프롬프트 메타데이터에 적는다. 쓸 만한 예시가 없으면direct로 돌아갔다고 밝힌다.
프롬프트 순서(SKILL 5절):
- 장면·배경과 구도: 프레임 안에 무엇이 어떻게 놓이는지, 여백
- 주체와 동작: 누가(무엇이) 무엇을 하는지, 한 가지에 집중
- 재질·조명·팔레트·렌즈나 렌더 스타일: "부드러운 측광", "무광 종이 질감", "네이비와 그린 2색"처럼 구체적으로
- 이미지 안 문구: 정확한 문구를 따옴표로 그대로 적고, 글자 수를 최소로 한다. 결과에서 오탈자를 반드시 확인한다
- 편집 관계:
[Image #N]끼리의 역할(예: "[Image #2]의 재킷을 [Image #1]의 인물에 입힌다") - 제약과 불변 조건: 건드리면 안 되는 것(얼굴, 포즈, 배경, 카메라 각도)을 명시한다. 후속 편집마다 반복한다
예시 쿡북은 reference 모드에서 검색으로 필요한 항목만 찾는다. 파일 전체를 읽거나 붙여 넣지 않는다.
rg -n '^### No\..*(poster|portrait|product|infographic)' \
.context/zenmux-image-generation/references/awesome-gpt-image-2.md- OpenAI 계열 예시:
awesome-gpt-image-2.md(저장소 사본) - Gemini 계열 예시:
awesome-nano-banana-pro-prompts.md(저장소 사본) - 쿡북은 프롬프트 영감일 뿐 API의 근거가 아니다. 구조를 빌리고 주제는 바꾼다.
9. 비용과 안전
- 유료 호출 전 확인: 프롬프트와 파라미터(모델, 크기, 품질, 장수)를 보여 주고 사용자가 확인한 뒤에만 생성한다.
--n 1습관: 공장 기본 장수는 4다. 사용자가 변형을 요청했을 때만 4장을 쓴다. 폴백, 모델 비교, 시험 호출은 항상--n 1이다. 공급자가 여러 장을 거부하면--n 1로 여러 번 호출한다.- TLS 인증서: 이 Mac에서는 Node가 curl이 받아들이는 발급자를 신뢰하지 않아 맨 명령이
Error: Connection error.로 실패한다. 생성 명령 앞에NODE_EXTRA_CA_CERTS=/opt/homebrew/etc/ca-certificates/cert.pem을 붙인다. TLS 검증을 끄지 않는다. - 키 취급: 키를 채팅, 인자, 로그에 넣지 않는다. 존재 확인은
grep -c만 쓴다. - 저장소:
output/,prompts/,references/,refresh-state.json은 자동으로 Git에서 무시된다.node_modules는 커밋하지 않는다. - Grok 구독 이중 결제 방지:
x-ai/grok-imagine-*(위 표의x-ai/grok-imagine-image-2.0)은 이 머신에서 고르지 않는다.
10. 흔한 실패
| 증상 | 원인과 처방 |
|---|---|
Error: Connection error. | Node가 인증서를 신뢰하지 못함. NODE_EXTRA_CA_CERTS=/opt/homebrew/etc/ca-certificates/cert.pem을 앞에 붙인다 |
| 의존성 없음 오류 | npm ci --prefix "$SKILL"을 먼저 한다. 허브로 설치해도 node_modules는 생기지 않는다 |
| 키가 없다는 오류 | grep -c '^ZENMUX_API_KEY=.' ~/.hermes/.env로 확인하고, 쓴 뒤 새 세션을 시작한다. execute_code가 아니라 터미널 도구로 실행한다 |
| 모델을 찾을 수 없음 | list_models.sh --force로 현재 목록을 받아 정확한 ID를 쓴다. 기억으로 지어내지 않는다 |
| 크기 오류 | 비율을 유지하는 가장 가까운 유효 크기를 고른다. gpt-image-2.5-flare는 프리셋 크기를 쓴다 |
| 참조 이미지 거부 | PNG, JPEG, WebP로 변환하고 모델의 입력 한도 아래로 줄인다 |
| 마스크가 먹지 않음 | 마스크는 첫 번째 입력에만 적용된다. PNG, 4MB 미만, 첫 이미지와 같은 크기, 편집 영역이 완전 투명인지 확인한다 |
| 투명 배경이 불투명으로 나옴 | --background transparent와 PNG/WebP를 함께 지정하고 generate:openai로 만든다. Vertex 경로는 background를 지원하지 않는다 |
| 공급자가 여러 장을 거부 | --n 1로 같은 접두사를 써서 여러 번 호출한다. 런 ID 때문에 파일명이 겹치지 않는다 |
| 같은 비율이 안 나옴(Gemini 경로) | --aspect-ratio와 --image-size를 명시한다. 생략하면 공급자 기본값이 쓰인다. 공급자가 요청과 다른 MIME 형식을 줄 수 있어 스크립트가 확장자를 맞춰 저장한다 |
의도와 다른 --n 4 과금 | 폴백·시험은 항상 --n 1을 명시한다 |
| 키가 채팅이나 출력에 노출됨 | 즉시 키를 폐기·재발급하고 ~/.hermes/.env만 갱신한다 |
11. 다음 스킬
프롬프트를 직접 쓰기 어려울 때는 프롬프트를 만들어 주는 스킬로 시작하고, 그 영어 프롬프트 파일을 이 스킬의 prompts/에 두고 모델을 골라 생성할 수 있다.
- 별연 삽화:
dreamer-star-ip - SaaS 히어로 일러스트:
saas-illustration